 德阳吧
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
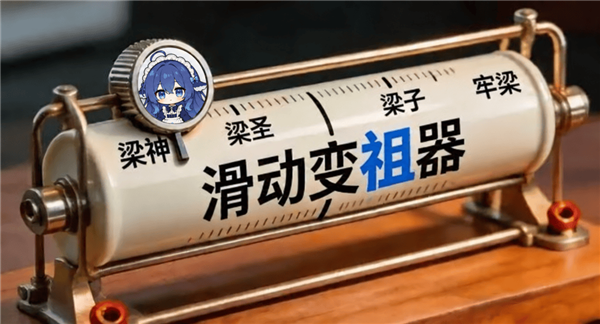
不是,梁文峰你怎么什么都往外掏啊。模型开源就算了,什么叫推理框架,内部账本全都公开了。明摆着告诉你,手把手跟上的话,一张卡一天就能收米 6100 块。要知道,即使是现在最贵的 B300,租一个小时也就不到 60 块 ( 9 刀 )。妥妥的印钞机啊。靠着这番操作,滑动变阻器的评级估计又要调回梁圣了,因为他是真的想教会大家怎么用 AI 来赚钱,别影响他们做 AGI。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
那问题来了,这回开源的推理框架到底是个啥呢?简单点理解,如果把大模型比作一家餐厅,那么闭源模型就只公开了菜单,你点啥菜,它上啥菜,菜是怎么做出来的, 谁也不知道。开源模型,就是餐厅把自己做菜的菜谱公开了出来,大家都能照着菜谱做菜,但做出来的菜能还原到几成水平,就得看你自己的火候了。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
而这次 DeepSeek 开源出来的推理框架,就好比一整个记录做菜过程的 4K 120 帧蓝光高清杜比原盘视频。不但拍下了做菜的每一个步骤,就连用什么灶、买哪儿的菜、甚至炒菜要颠几下勺都给你记录下来了,生怕你学不会。过去很多模型公司都有开源模型的权重,但是很多第三方厂商拿了这些开源模型后,却发现怎么也做不出官方的味道,要么是成本压不下来,要么是模型效果不太行。这其中差的,就是推理框架这些具体的细节经验。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
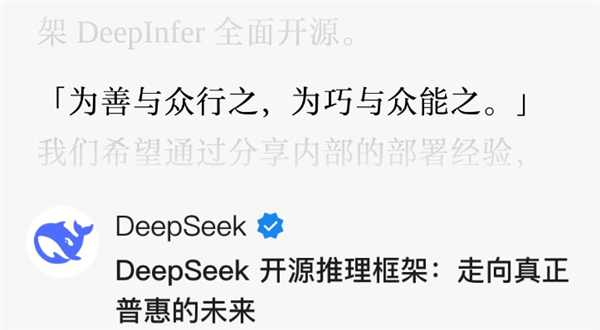
于是 DeepSeek 索性开源开到底,除了开源推理框架 DeepInfer,让算力集群能高效运行,顺手还配了套 DeepSeek Recipe,方便各种第三方 API 都能正确跟 DeepSeek 交流。更贴心的是,考虑到硬件不同,人还把华为和英伟达的适配都一起搞定了,真就是手把手的懒人教程。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
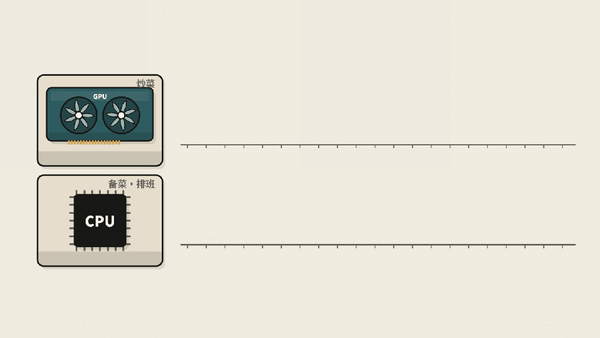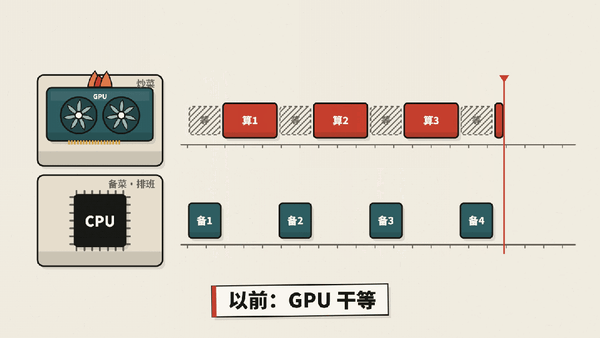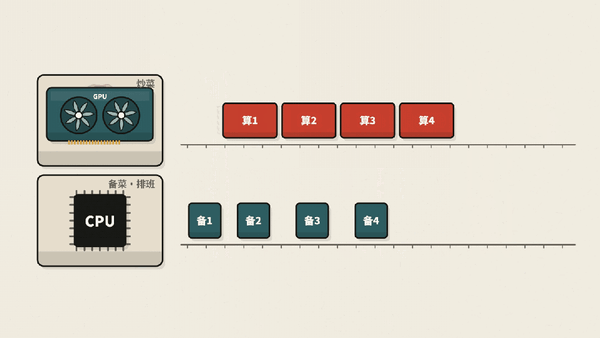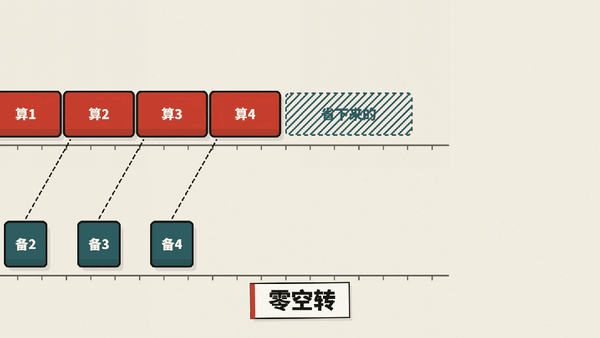
咱先来讲这个 DeepInfer,说说它是怎么把 GPU 性能榨干的。首先,为了算力输出更稳定,它构造了一条 GPU 和 CPU 分工合作的 流水线。以前 GPU 每算完一轮,还得等 CPU 处理结果、安排下一批任务,中间免不了摸鱼。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
现在改成了 GPU 算这一轮的时候,CPU 就提前准备下一批任务,双方交叉干活,无缝衔接。除此之外,GPU 内部也被分成了两拨,8 卡的小机器负责读取输入,64~128 卡的超级节点则专门处理输出,并行效率彻底拉满。果然,想要从寸土寸金的显卡上薅羊毛,一秒都不能空转呐。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
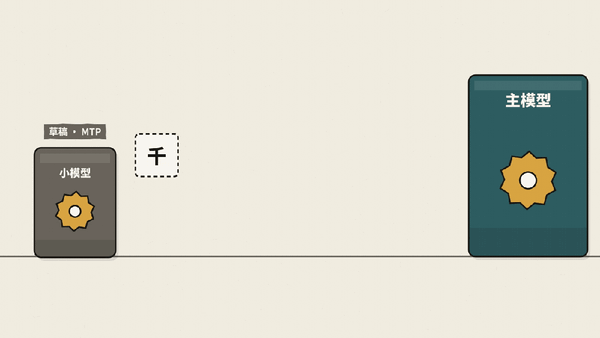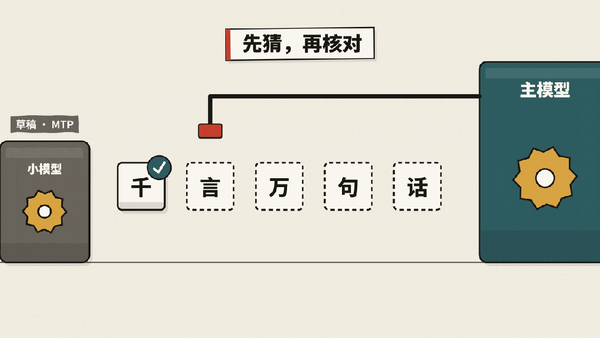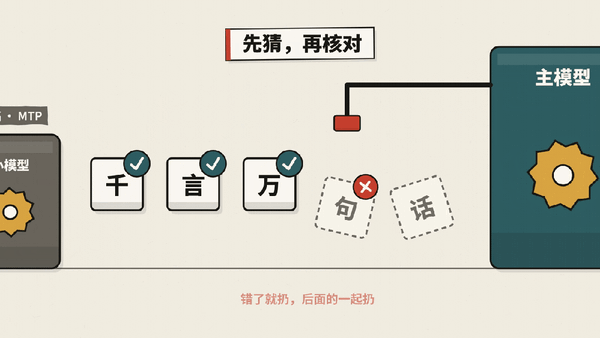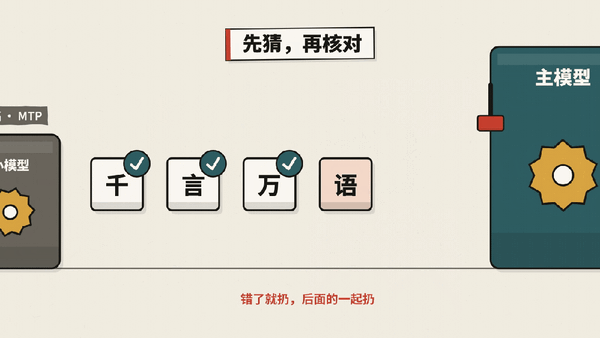
但话说回来,流水线再怎么连轴转,也架不住模型本质上还是个词语接龙机,token 只能一个一个往外蹦。诶,那就不能一回多吐几个么?能的兄弟,能的。DeepSeek 听罢掏出了祖传绝活: 提前猜答案。这套手艺早在 DeepSeek V3 的时候就引入了,那时候叫 MTP,多 Token 预测,就是让小模型先多猜几个 Token,再让主模型核查,对的留,错的扔。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
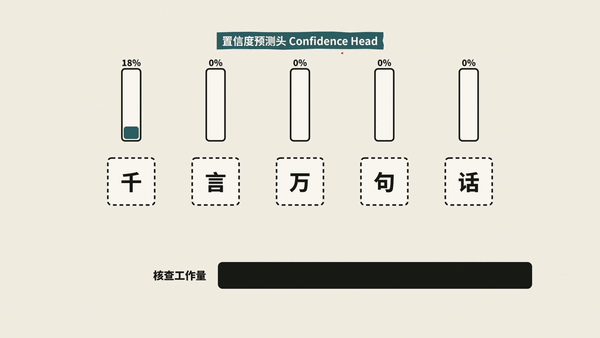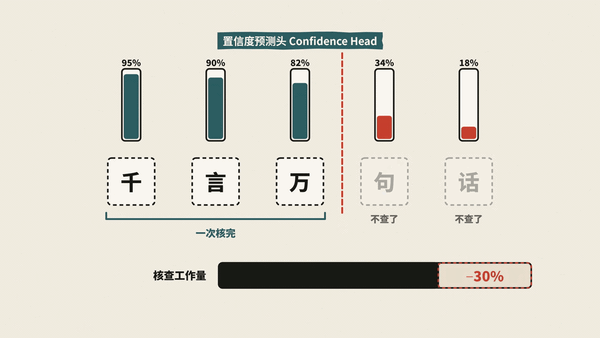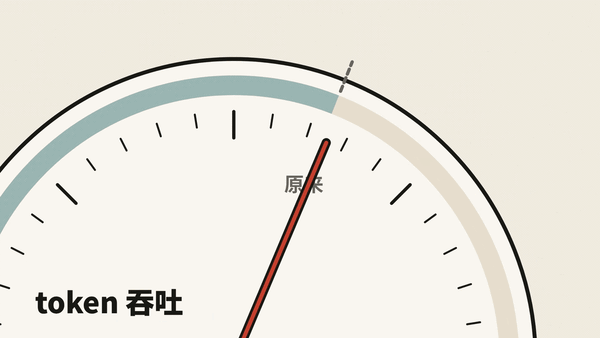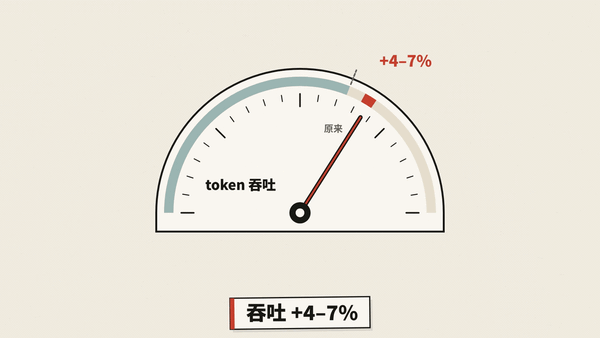
今年七月份又来了波升级,发布了 DSpark,批量生成草稿,提升预测的数量,又优化了核查验证的算法。这回就更彻底了,索性手把手教你到底怎么验证更省事儿。主要就是靠这个 Confidence Head,置信度预测头,提前给这些 token 预估个靠谱程度。靠谱的多查,不靠谱的就少查几个,不必每次查到底。测试下来,相比之前老老实实挨个查,减少了足足 30% 的工作量,提高了 4%~7% 的 token 吞吐。属于是牙缝里都给你抠出个鸡腿。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
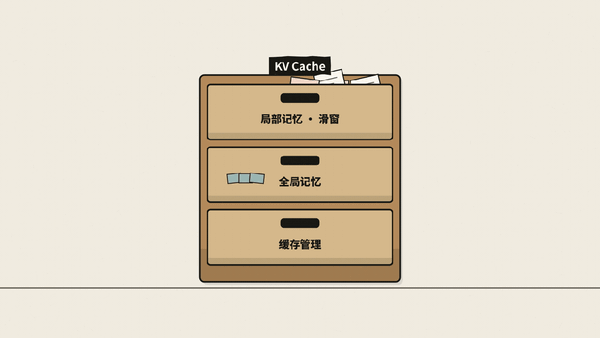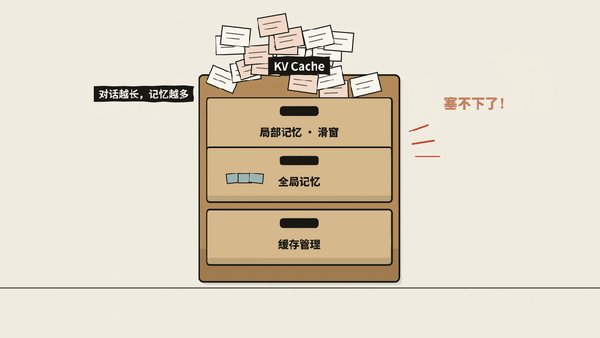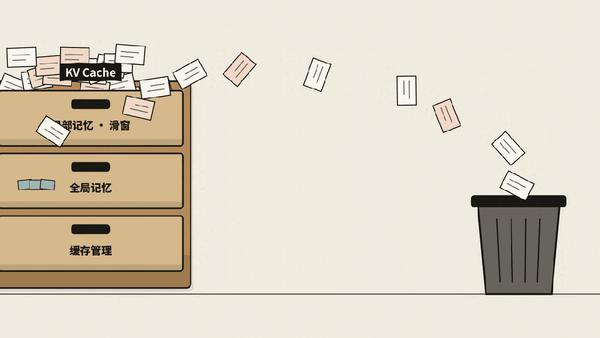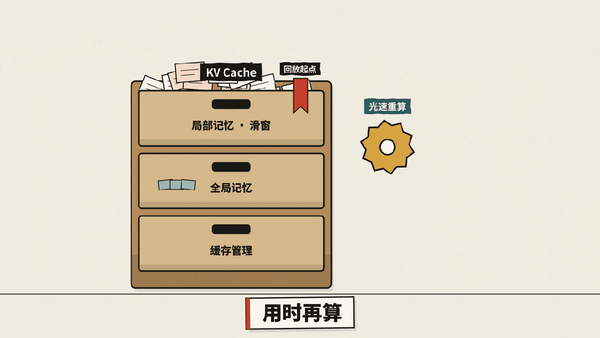
当然,除了计算发力,负责缓存的老熟人 KV Cache也是重头戏。咱都知道,V4.1 Flash 出厂时,硬盘里的缓存占用压缩到了前代的八分之一。除了压缩策略发大力,还用到了一项叫 SWA Bounded Replay( 有界回放 ) 的技术。这玩意儿设计相当巧妙,能直接帮服务器省下海量的硬盘和带宽。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
以前大模型为了让自己在聊天的时候不失忆,会把长期记忆和短期记忆都给一股脑的塞到脑子里,直接把脑子给塞爆了。现在用上了 SWA 有界回放,就可以把脑子里最占地方的局部记忆给先丢了,等到要用的时候再光速计算出来恢复一下。这一改,处理输入的计算量直接砍半,省钱省到了极致。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
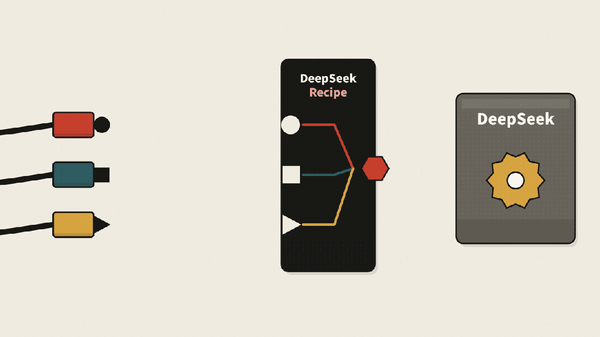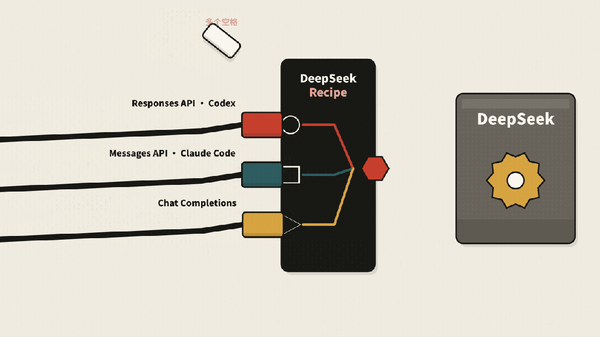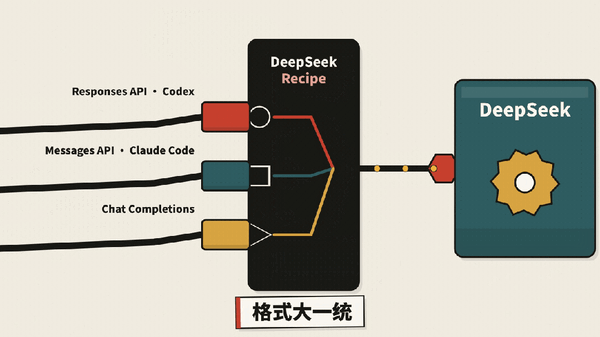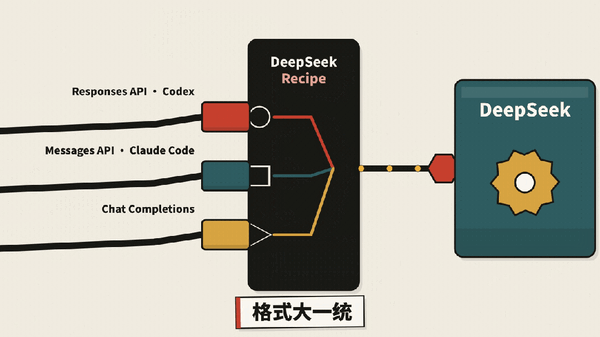
当然,DeepInfer 牛批,另一套 DeepSeek Recipe 同样不能低估。之前咱们用开源模型,很容易遇到个怪事:明明是同一个型号的模型,接到不同平台和工具里,跑出来的味道却不太一样。这是因为大模型对输入的格式极其敏感,现在市面上 OpenAI、Anthropic 等各家接口的标准五花八门。在转换时哪怕错一个特殊字符、多一个空格,模型的思考逻辑和工具调用就会当场乱套。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
这次的 DeepSeek Recipe 就是来大一统的。甭管你是 Codex 发来的 Responses API,还是 Claude Code 用的 Messages API,它都能转成适合 DeepSeek 的格式。让你在自己家里部署,也能像官方原版的丝滑体验看齐。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
当然了,DeepSeek 这次其实稍微藏了一手, 后面还会继续更新。人在公告里也直说了,由于推理系统中的 KVCache 管理与负载均衡组件因与内部基础设施耦合较深,相关代码目前尚未完整开源。这也意味着现在开源出来的这些代码,其实更利好于软件芯片厂商来做调试,或者是利好中小企业开发者来做自己的私有化部署。
一张算力卡日入6000块? DeepSeek开源赚钱焚决了
但是对同样规模的云服务大厂和直接竞争对手来说,就有点不够用了。毕竟把几十张卡的性能榨干是一回事,怎么把机房里成千上万张卡串起来、在亿级并发下做全局调度和缓存复用,又是另一回事。不过哪怕只有现在这些,从底层算子到双平台适配的 DeepInfer,也足够芯片厂商和开发者们爽吃一阵子了。最后只能说,千言万语,感谢梁圣开源了。
版权声明
本站所有文章来源于本站原创或网络,如有侵权请联系删除。文章观点并不代表本站观点,请网友自行判断,如涉及投资、理财请谨慎应对!
相关文章

作者文章
- 多家游戏厂商紧急维护!高危漏洞引爆 任天堂也遭重 18分钟前
- 全球互联网今夜炸雷 大量网站关站停服:急修PHP高危漏洞 24分钟前
- 又一国产路虎卫士登场!北汽星钽5X预售:13.99万起 81.9度大电池 25分钟前
- 现在复活一款老游戏 只需要8小时了 26分钟前
- SpaceX越来越像一家AI算力公司 1小时前
发表评论:
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。